Cinquante-six segments, et autant de visionnage qu'avant
Je voulais que JEV me fasse regarder moins de vidéo. Je lui ai envoyé 56 segments de cet enregistrement, chacun avec son contexte. L'idée : voir s'il pouvait en écarter une partie avant le visionnage complet.
Il a répondu à 30 requêtes. Les 26 autres se sont terminées par une erreur de surcharge. Parmi ses propositions d'écarter un segment, aucune n'a atteint le seuil de confiance fixé avant le test.
Les 56 segments étaient donc à regarder quand même. Dans cette expérience, JEV ne m'a pas allégé le travail.
Ce résultat est arrivé après l'enregistrement. Dans la vidéo, j'essaie encore de comprendre ce qu'est JEV et à quoi il pourrait me servir. Je demande à ChatGPT des exemples plus simples, je me dispute avec Claude à propos d'un moyen de paiement, et je demande à Qwen de vérifier ce qu'on raconte.
J'ai gardé mes questions, parce qu'elles sont le sujet. Avant d'ouvrir les outils, je n'avais pas encore compris tout ça.
L'exemple qui m'a fait comprendre
Il me fallait d'abord une explication que je puisse relier à un travail de tous les jours. L'exemple : un client écrit que ses chaussures sont arrivées dans la mauvaise pointure.
Le logiciel connaît déjà les destinations possibles : retours, livraison, facturation. JEV choisit parmi elles. Ensuite, c'est le reste du logiciel qui décide ce qu'il advient du message.
La documentation de TypeSafe décrit JEV comme un modèle pour les décisions structurées. On peut lui demander de choisir, de noter, ou de donner la probabilité qu'une affirmation soit vraie. Ça m'a aidé à comprendre pourquoi je ne m'en servirais pas comme d'une fenêtre de discussion de plus.
J'ai ensuite voulu appliquer cette idée à une liste d'entreprises. Pourrais-je trouver les informations, donner mes critères à JEV, puis laisser les cas difficiles à un modèle plus gros ?
C'était une piste possible, et je posais des questions dessus. Je n'ai pas montré JEV en train de produire une liste finalisée de prospects qualifiés. La vidéo ne prouve pas non plus que cela ferait économiser de l'argent sur ce travail.
J'ai aussi mis du temps à saisir la différence entre nettoyer la liste et la classer. Corriger un numéro de téléphone ou supprimer un doublon ne dit pas si une entreprise est un bon prospect. Je me demandais pourquoi il faudrait encore une passe sur des données déjà nettoyées.
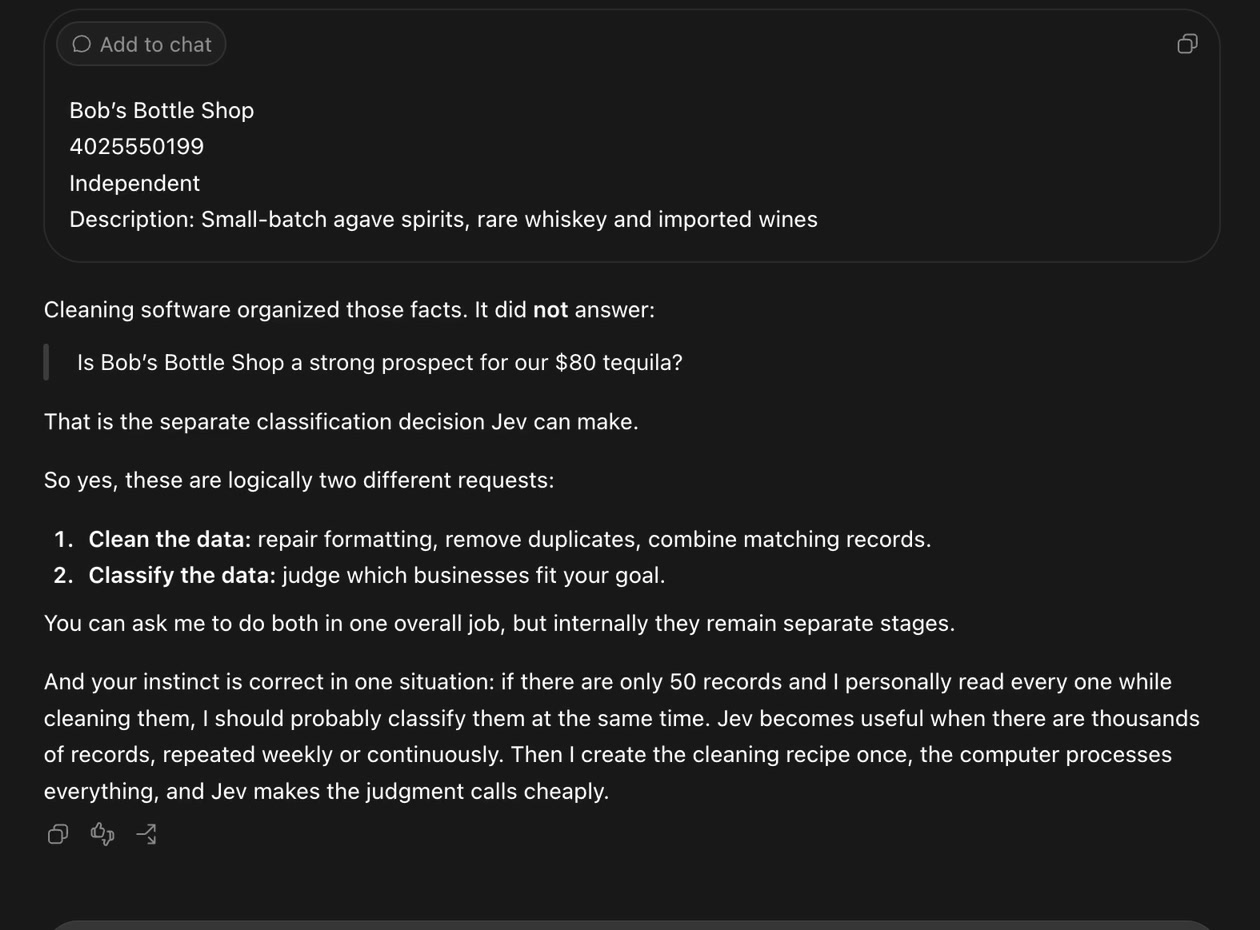
Si j'essayais ensuite l'idée de la liste de prospects, je garderais une question bien ciblée. Je rassemblerais les informations de départ, je définirais les critères pour les entreprises, et je vérifierais les choix obtenus avant de contacter qui que ce soit. Une probabilité me donnerait une chose de plus à contrôler. Elle ne prouverait pas que quelqu'un veut un site web.
Deux réponses qu'il a fallu laisser de côté
Pendant que j'essayais de faire marcher JEV, Claude m'a dit que mon moyen de paiement n'était pas enregistré sur le compte. J'ai ouvert la page de facturation et je lui ai montré la carte.
Claude a alors reconnu qu'il avait regardé le mauvais signal. La carte était bien là. Cet échange explique ma réaction dans la vidéo. Je ne le présente pas comme un test de toutes les réponses de Claude.
Plus tard, j'ai interrogé Qwen sur JEV et je lui ai demandé s'il existait déjà quelque chose de semblable. Sa réponse m'a conduit au projet de Harsha Gundala basé sur Qwen, sur Hugging Face.
Sur le coup, je l'ai appelé « JEV chinois », en réagissant à la réponse de Qwen. La page que j'ai ouverte est une reproduction basée sur Qwen. Cela ne dit rien de la nationalité de l'auteur, ni d'une éventuelle équivalence avec les capacités de JEV.
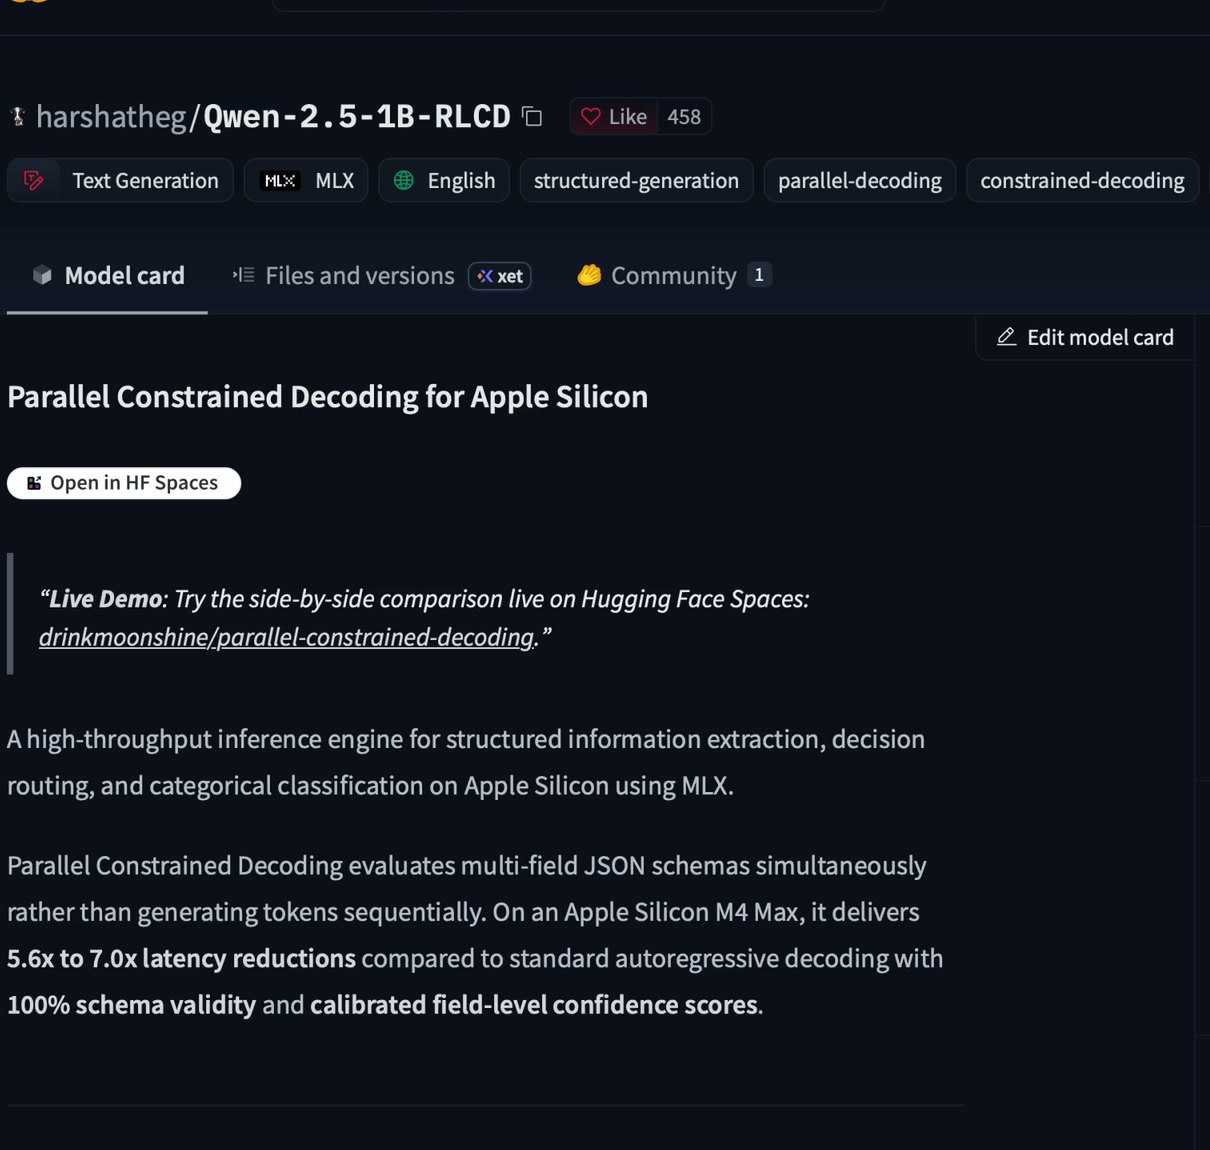
La fiche du modèle décrit un décodage contraint en parallèle sur Apple Silicon et indique une licence Apache 2.0. L'affirmation « construit en deux heures » vient de l'annonce de Harsha, et d'elle seule. Je n'ai pas refait ce chrono, ni testé si les deux se valent.
Je ne transformerais pas non plus « ne peut pas halluciner » en « ne peut pas se tromper ». L'article de lancement de TypeSafe rattache son chiffre de zéro à la conformité garantie au schéma, et précise que ce chiffre n'est pas mesuré. Choisir une réponse autorisée et choisir la bonne réponse, ce n'est pas la même chose.
Ce que le test de montage a vraiment donné
Le travail que je pouvais tester tout de suite, c'était cette vidéo. Je voulais savoir si JEV pouvait m'épargner assez de relecture pour mériter une place dans ma façon de travailler.
Le test portait sur les segments d'origine de la transcription, avec le contexte autour. J'ai fixé à 90 % le seuil pour écarter un segment avant de lancer les requêtes. Les segments en échec, incertains ou sous ce seuil restaient dans la relecture normale.
Sur les 30 réponses, 24 disaient de garder, cinq proposaient d'écarter et une était incertaine. Aucune des cinq propositions d'écarter n'a atteint le seuil. J'ai gardé le seuil tel quel, au lieu de le baisser après coup pour afficher un gain.
| Ce que j'ai vérifié | Résultat |
|---|---|
| Segments envoyés | 56 |
| Réponses obtenues | 30 |
| Erreurs de surcharge | 26 |
| Segments écartés sans risque selon la règle choisie | 0 |
| Contenu à revoir en moins | 0 % |
Les 30 réponses obtenues affichent 0 $ de frais de passerelle pendant la promotion. Les requêtes en échec n'ont renvoyé aucune donnée de facturation. C'est ce que montrent les relevés. Cela ne veut pas dire que ce type de traitement ne coûte jamais rien.
J'ai aussi fait deux passes de relecture séparées avec mes abonnements : une normale, une assistée par JEV. Elles ne demandaient pas exactement le même travail. Leurs durées et leurs nombres de tokens ne donnent donc pas de comparaison de coût fiable, et je ne peux en tirer aucun montant économisé.
L'observation audiovisuelle de Gemini 3.8 et mes vérifications de montage habituelles restaient nécessaires. JEV n'a pas choisi les coupes finales et n'a pas remplacé le visionnage du résultat. Il n'a pas fait la seule chose que j'attendais de lui.
Que mesurerais-je dans un autre test ?
Je prendrais un lot fixe dont j'ai déjà relu les réponses, puis je comparerais le même travail avec et sans JEV. Je compterais les erreurs, les surcharges, le travail de relecture qui reste et le coût des deux méthodes. Une réponse rapide ne servirait que si elle m'épargnait un travail que je peux arrêter de faire sans risque.
JEV ne sert-il donc à rien ?
Non. C'était un seul test de montage, avec une seule règle et un seuil élevé pour écarter un segment. Il ne dit pas si JEV est utile pour un travail de classement plus ciblé. Il dit seulement ce qui s'est passé quand je l'ai essayé ici.
Où trouver les outils de la vidéo ?
- TypeSafe AI et la documentation de JEV.
- La reproduction basée sur Qwen que j'ai ouverte.
- Le profil Hugging Face de Harsha Gundala.
L'enregistrement complet montre comment je suis passé de « c'est quoi, ce truc ? » à un test que je pouvais vérifier. Ma prochaine question : quel travail plus ciblé donnerait à JEV un deuxième essai équitable ?
Voir le test en entier
Regardez l'analyse complète de JEV sur YouTube (en anglais) pour la mise en place, l'échange avec Claude et la question posée à Qwen.
Côté publication, j'ai aussi expliqué comment j'utilise Repurpose.io, Buffer et Codex pour diffuser un seul enregistrement sur plusieurs plateformes.
← Tous les articles